把 drawio 二开成 AI 思维导图工具:架构设计与踩坑实录
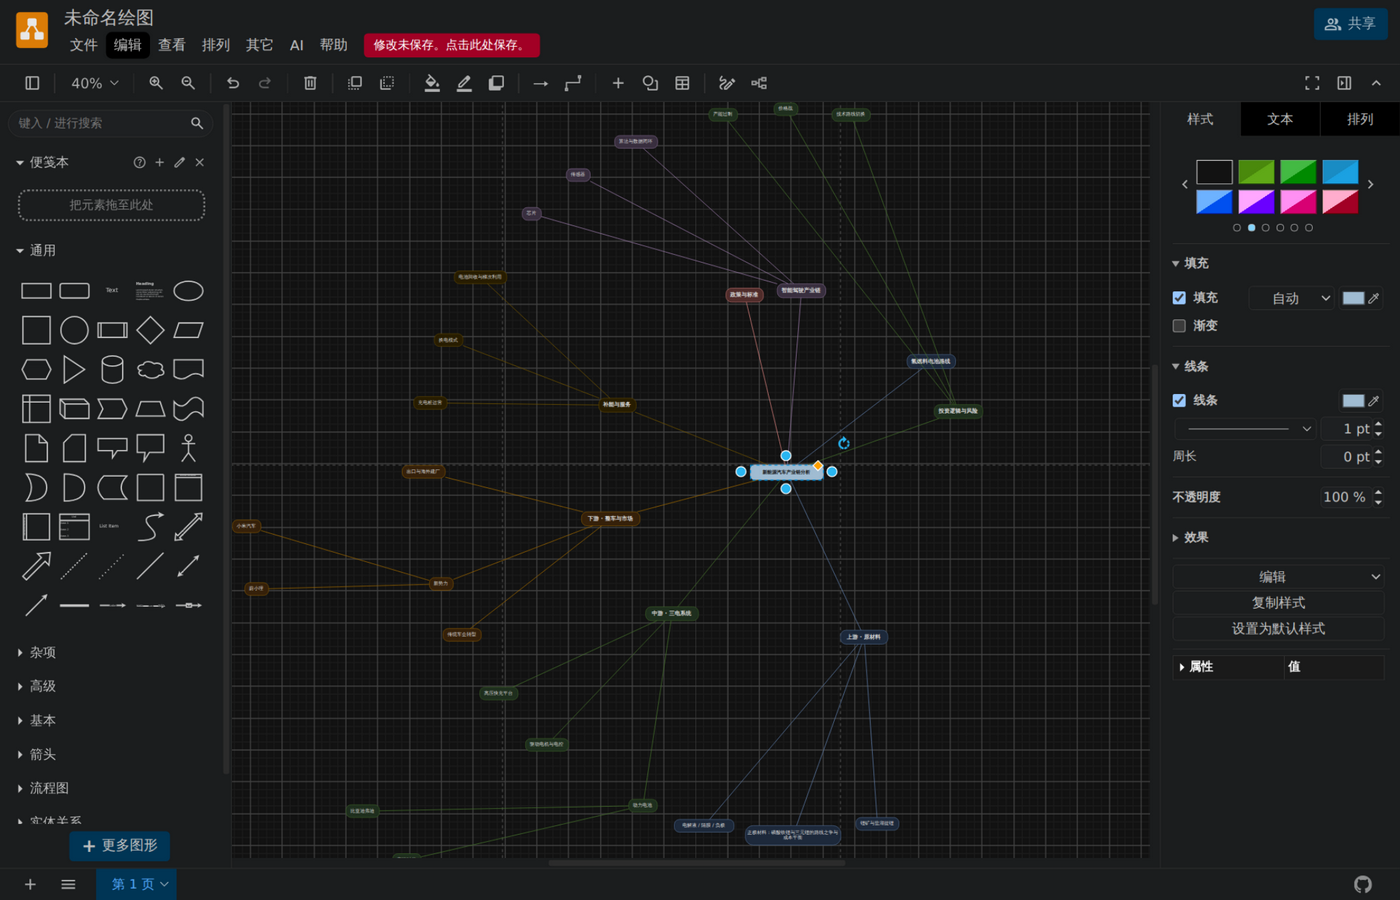
最近完成了一个对个人意义比较大的项目:MindmapAI——基于 drawio 二次开发的
AI 思维导图/思考图工具。给它一个主题、一篇文章、一个链接甚至一份 Word/PDF
文档,它能提炼要点、自我评审,然后在画布上自动画出一张结构化的图。
这篇文章记录整个项目的架构取舍和踩坑过程,代码已全部开源。
- 仓库:github.com/Bogucheese/MindmapAI
- 技术栈:TypeScript / drawio (mxGraph) / Electron / 零依赖 Node 脚本
一、为什么不直接 fork 改源码
二开 drawio 最容易想到的路是 fork 仓库直接改。我没走这条路,原因是两个:
- 合规。drawio 是 Apache-2.0 项目,直接在其源码里掺杂自己的代码再发布,
代码边界和声明都会变得模糊。我想让仓库里 100% 是自己的代码。 - 可升级。源码混改之后,上游每升一个版本都是一次痛苦的 merge。
最后的方案是「运行时拉取 + 补丁注入」:
- 仓库只放原创代码和一个
patches/目录(要注入上游文件的片段、资源、
pinned 的上游 commit hash); scripts/setup-upstream.mjs首次运行时按 pinned 提交浅克隆上游
drawio / drawio-desktop,然后把接入点(菜单、插件 script 标签、i18n 词条、
品牌资源)幂等地注入进去——注入用标记注释识别,重复执行不会重复插;webapp/在.gitignore里,随时删掉重拉,上游升级就是改一行 hash
再跑一次脚本。
这个结构让「我的代码」和「上游代码」在物理上完全分离,NOTICE.md 里把每项
注入逐条声明,Apache-2.0 的义务履行得很干净。
二、总体架构
┌─────────────────────────────────────────────────┐
│  webapp/ (上游 drawio, pinned commit, 运行时拉取) │
│  ┌───────────────────────────────────────────┐  │
│  │ js/ai/mindmap-ai.js  ← ai/ 模块打包的 IIFE │  │
│  └───────────────────────────────────────────┘  │
├─────────────────────────────────────────────────┤
│  ai/ (TypeScript 源码, esbuild → IIFE 插件)      │
│  ├─ ai/       OpenAI 兼容客户端 + prompt + schema│
│  ├─ agent/    生成管线 / Agent 工具循环 / 抓取    │
│  ├─ charts/   12 种思考图: 槽位协议→确定性布局    │
│  ├─ mindmap/  树模型 → 画布装配                  │
│  └─ ui/       对话框 / Agent 面板 / 菜单          │
├─────────────────────────────────────────────────┤
│  scripts/start.mjs  零依赖静态服务器(含抓取中继)  │
│  desktop/           Electron 壳(上游 desktop 注入)│
└─────────────────────────────────────────────────┘
核心 AI 代码都在 ai/ 目录的 TypeScript 模块里,esbuild 打成单文件 IIFE,
通过注入的 <script src="js/ai/mindmap-ai.js?v=N"> 挂进 drawio。
这样 AI 层完全独立:自己的单测(vitest)、自己的类型检查(tsc)、自己的构建,
不污染 drawio 的构建链。
三、核心设计:决策在模型,几何在代码
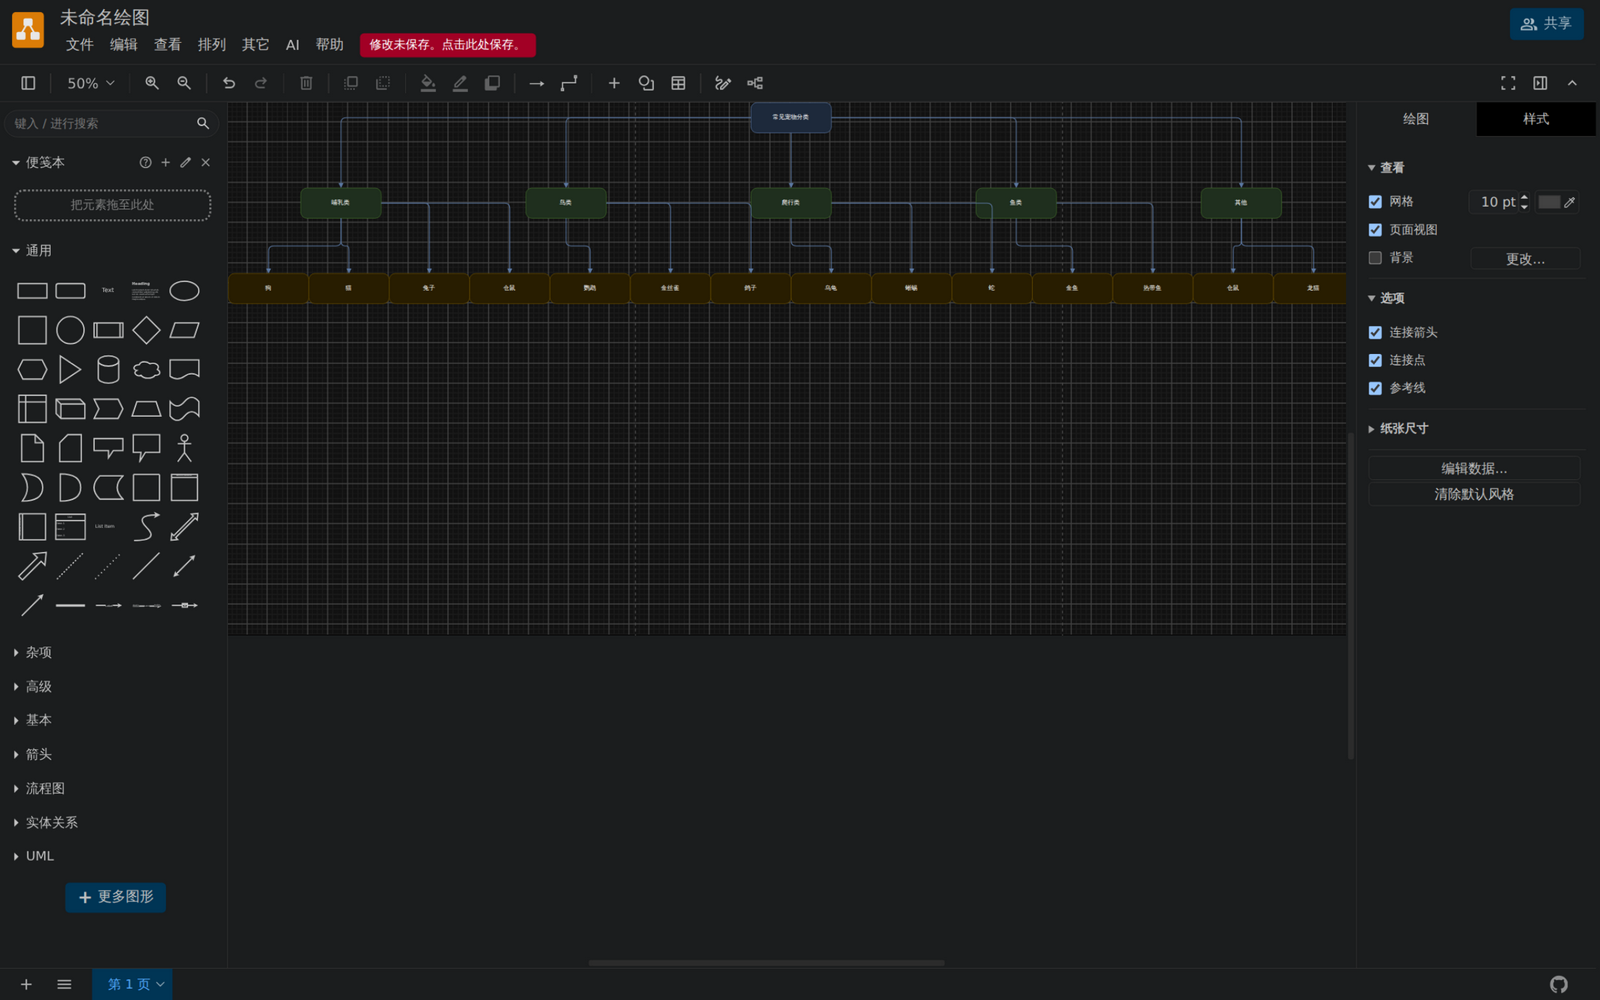
这是整个项目最重要的一条架构原则。让 LLM 直接输出画布坐标(x/y/w/h)几乎
必然得到一坨重叠错位的东西,所以我把职责切成两半:
- 模型只做内容和结构决策:12 种思考图各定义一个「槽位协议」
(一份 JSON schema 描述 + 示例),模型按协议填 JSON; - 代码做全部几何:每个图型一个确定性布局函数,输入槽位 JSON,输出带
坐标/样式/连线的中间表示,再统一装配到 mxGraph 画布。
以流程图为例,槽位协议长这样(节选):
{
  "title": "AI Agent 工作流程",
  "lanes": ["用户", "Agent", "工具"],
  "steps": [
    {"id": "s1", "label": "提出目标", "shape": "terminator", "lane": 0},
    {"id": "s4", "label": "目标达成?", "shape": "decision", "lane": 1},
    {"id": "s5", "label": "输出结果", "shape": "terminator", "lane": 1}
  ],
  "edges": [
    {"from": "s4", "to": "s5", "label": "是"},
    {"from": "s4", "to": "s2", "label": "否", "dashed": true}
  ]
}
早期版本流程图只支持「步骤 i 连 i+1」的线性链,用户实测后直接吐槽
「连线一点也不规范」——decision 分支根本画不出来。于是协议加了显式edges(分支/回退都能表达),布局层把所有连线统一成 drawio 标准的
正交路由,按两端几何关系自动选连接点:顺流沿流向、回退侧面绕行、
跨泳道侧向一跃。几何规则全部有单测固化(节点不许越出泳道、连线必须有
定向连接点、禁止斜直线)。
四、来源驱动的生成管线:每一步都有据可查
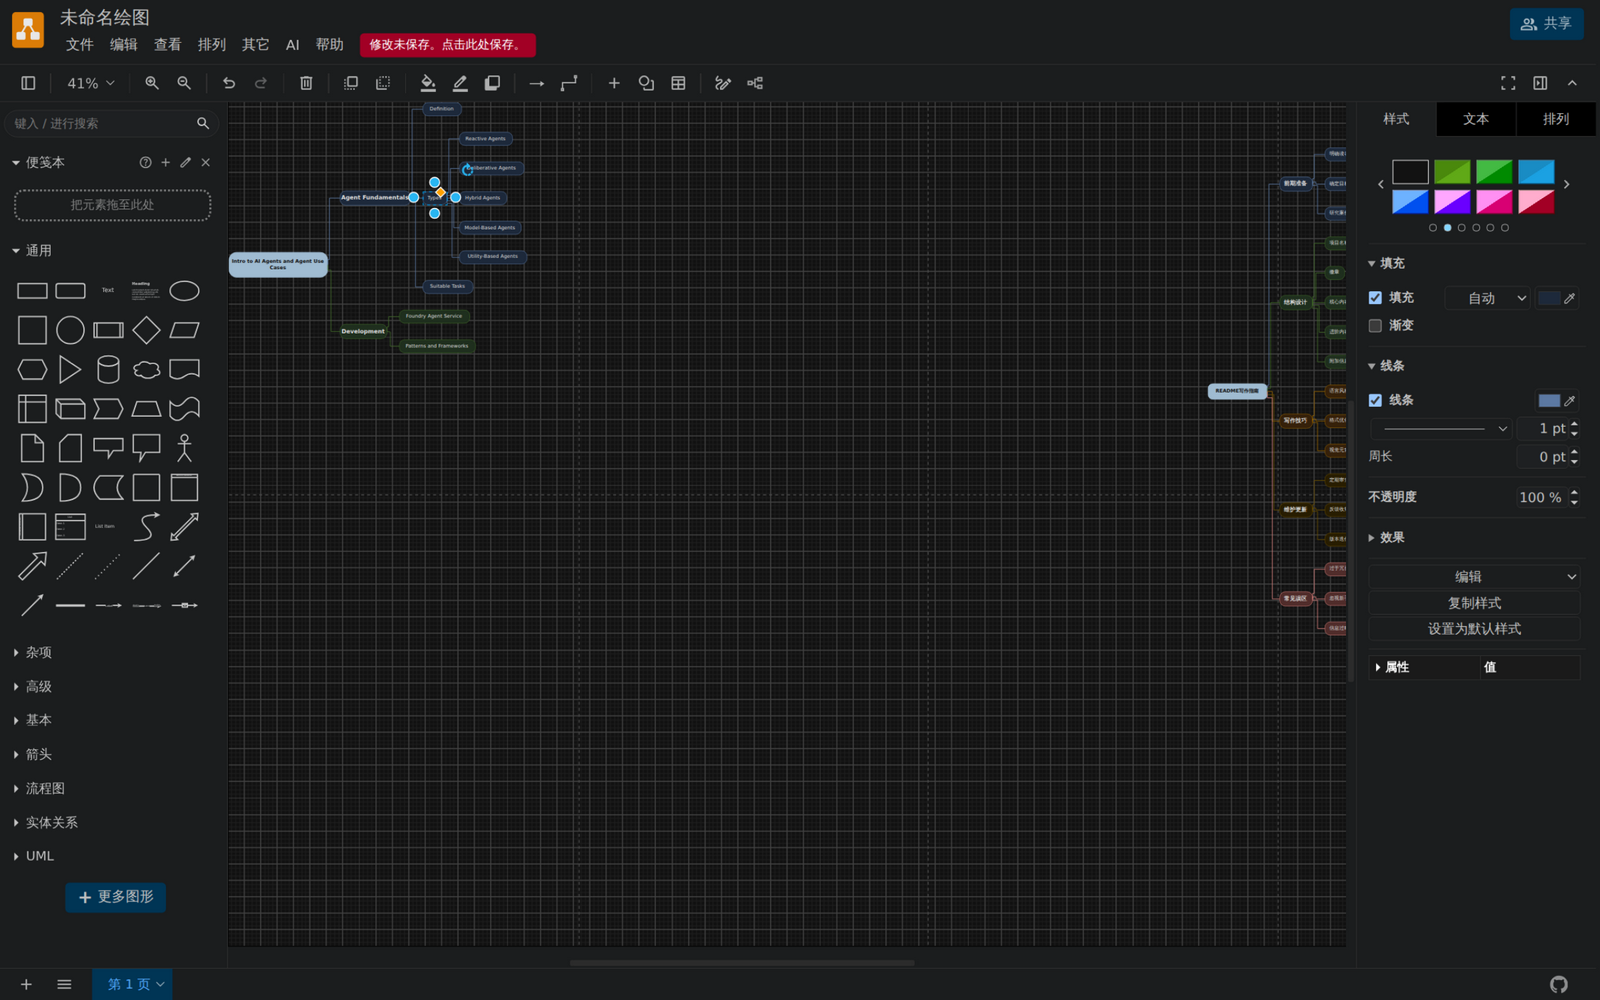
「贴一篇文章生成导图」的管线不是一次 LLM 调用,而是四段:
- 分块:文档按 Markdown 标题切章节,超长章节按段落装箱(纯确定性代码);
- 提炼:逐块提炼要点,必须带原文引文(quote 字段);
- 架构:基于全部要点生成导图骨架,每个节点回填支撑它的要点 id;
- 评审:grounding / coverage / specificity / structure 四维打分,
不达标自动回炉重构一次。
引文不是装饰品:它跟着节点存进 .drawio 文件(节点 value 上的 mm-*
属性),重开文件悬停节点还能看到「这句话是从原文哪句来的」。来源驱动的
价值就在这里——图不是模型凭空编的,每个节点都有出处。
五、Agent 模式:把控制流真正交给模型
管线模式之外还有一个 Agent 模式(生成对话框里勾选):模型不再是被动的
JSON 生成器,而是拿到一组工具自主工作:
- 思考图:
read_notes(查要点)/fetch_url(抓网页)/submit_chart
(提交槽位,代码校验不过就把错误喂回去让它自己修,最多 3 次提交); - 思维导图:
add_node/update_node/finish_changes等 7 个工具,
模型逐个节点放置,放完自我检查还能再修一轮; - 生成完成后,Agent 面板的输入框还能继续下指令(「把术语统一为 AI
Agent」),Agent 用工具改完自动重排画布。
侧边栏的 Agent 面板把这一切实时播出来:哪条要点被提炼、评审打了多少分、
每次工具调用的参数摘要——不是黑盒转圈,是真的能看见它在干什么。
六、踩坑实录
开发中踩的坑比写的代码更有记忆点,挑六个有代表性的:
1. 浏览器 CORS:抓取功能在浏览器里必然残废
链接模式要抓第三方网页,浏览器直连被 CORS 拦截,公共代理 r.jina.ai 在
国内网络直接超时。解法:抓取本来就不该在浏览器里做——应用本来就靠start.mjs 这个本地服务器跑,给它内置一个同源中继GET /mm-fetch-proxy?url=<目标>,服务端发起请求(无 CORS)原样回传。
抓取链变成:直连 → 同源中继 → 公共代理,浏览器模式开箱即用,不用配任何东西。
2. URL 拼接吃掉端口号
中继联调时一度怎么都 404:拼出来的请求路径是 /?url=... 而不是/mm-fetch-proxy?url=...。原因是我写了 ${origin}?url=${target}——
origin 没有尾斜杠时,http://127.0.0.1:8000?url=x 里的 ? 被 URL 解析器
当成查询串起点,路径部分直接没了。教训:URL 拼接永远用构造器或显式路径,
别拼字符串。
3. PDF 的 FlateDecode 不是裸 deflate
文档转导图功能要零依赖解析 PDF(不引 pdf.js):解压内容流再按 Tj/TJ
文本操作符拼文本。第一版用 DecompressionStream('deflate-raw') 死活解不出,
查了 PDF 规范才发现 FlateDecode 是 zlib 封装(RFC 1950),要带头部和
校验和,对应 'deflate';少数生成器才写裸流。现在两种都试,zlib 优先。
(顺带:docx 解析也是零依赖——中央目录定位 word/document.xml,
裸 deflate 解压,XML 粗提取。)
4. sed 的 & 展开
批量往 i18n 资源文件插词条时用了 sed,替换文本里的 &
(”Summarize & suggestions”)被展开成「整个匹配行」,菜单标签变成了Summarize aiChartTooSmall=Chart content is too thin. suggestions…
这种缝合怪。资源文件批量改动,用 perl 或 Node 脚本,别用 sed。
5. drawio 的暗色主题信号藏在哪
Agent 面板要跟随编辑器暗色主题。先猜 ui.theme,是 null;再猜Editor.currentTheme,是 ‘kennedy’(那是界面布局变体,不是明暗)。
翻上游源码才找到真信号:Editor.darkMode 布尔值 + darkModeChanged
事件——新版 drawio 把明暗和布局拆成了两套系统。顺着这个事件做重渲染,
切主题时面板按事件历史重播卡片,会话内容不丢。
6. 首次点击菜单,面板反而消失
「Agent 面板」菜单项的行为是 ensureAgentPanel(ui).toggle():面板首次
创建时默认可见,toggle() 立刻把它藏了——用户第一次点击什么都看不到,
要点第二次。一行修复:初始 display:none。这种 bug 单测抓不到,
只有真点一遍才会发现,也是后来补浏览器 E2E 的直接动机。
七、测试与工程化
- 单元测试:vitest,21 个文件 162 个用例。布局几何(零重叠/泳道不越界)、
抓取回退链、文档提取(手搓 zip/pdf fixtures)、槽位校验、主题/语言切换
重渲染都有覆盖; - Mock LLM 服务器(
ai/dev-mock-server.mjs):OpenAI 兼容端点,按
system prompt 里的[MM-STAGE:xxx]标记路由到固定脚本响应,连
function calling 的tool_calls都能演。浏览器里把 Base URL 指到它,
不烧一分钱 quota 就能跑完整生成链路的 E2E; - 浏览器 E2E:用浏览器自动化真实点击 UI(开对话框、填链接、注入文件、
看画布单元格),控制台报错和菜单结构都能断言; - 打包链路:esbuild 出 IIFE → 注入上游 bootstrap(
?v=N版本号防缓存)→
Electron 壳走mmAiFetch主进程通道抓网页(天然无 CORS)。
八、路线图与链接
已完成:三来源生成(主题/粘贴/链接)、12 种思考图、评审管线、Agent 模式、
桌面版打包、文档转导图(Markdown/Word/PDF)、总结与优化建议、面板暗色主题、
流程图分支连线。
待办:Markdown 双向编辑、XMind/Freeplane/OPML 导入、macOS/Linux 打包与签名。
如果你对「LLM + 图形编辑器」这个方向感兴趣,欢迎来仓库看看:
github.com/Bogucheese/MindmapAI。
本地跑起来只要一句 node scripts/start.mjs(首次自动拉上游),
配上任何 OpenAI 兼容端点就能用。